MCU란 무엇인가 — OS 없이 도는 컴퓨터
임베디드를 처음 만지면 가장 낯선 것이 "프로그램이 끝나면 안 된다" 는 점이다. PC 프로그램은
main이return하면 OS가 정리하고 끝난다. MCU에는 돌아갈 OS가 없다.main이 끝나면 갈 곳이 없어 정의되지 않은 동작으로 빠진다.이 한 가지 차이에서 임베디드의 거의 모든 것이 나온다.
MCU와 MPU — 무엇이 다른가
| MCU (마이크로컨트롤러) | MPU (마이크로프로세서) | |
|---|---|---|
| 예 | STM32F4, ESP32, AVR | 라즈베리파이의 BCM, i.MX |
| 메모리 | 칩 안에 Flash·SRAM 내장 | 외부 DRAM 필요 |
| OS | 없거나 RTOS | 리눅스 등 범용 OS |
| 부팅 | 전원 넣으면 수십 µs 안에 코드 실행 | 수 초 (부트로더 → 커널 → init) |
| 전력 | mA~µA | 수백 mA~W |
| 가격 | 수백 원~수천 원 | 수천 원~수만 원 |
핵심은 "메모리가 칩 안에 있다" 는 것이다. 그래서 외부 부품이 거의 없어도 돌고, 전원을 넣자마자 명령을 실행할 수 있다.
MCU 한 칩 안에 들어 있는 것

┌──────────────────────────────────────┐
│  CPU 코어 (Cortex-M4)                │
│  ├ Flash  512KB  ← 코드가 여기 산다  │
│  ├ SRAM   128KB  ← 변수가 여기 산다  │
│  ├ NVIC          ← 인터럽트 컨트롤러 │
│  └ 주변장치                          │
│     GPIO · UART · SPI · I2C          │
│     Timer · ADC · DMA · WDT          │
└──────────────────────────────────────┘
        └ 이 전부가 하나의 칩이다
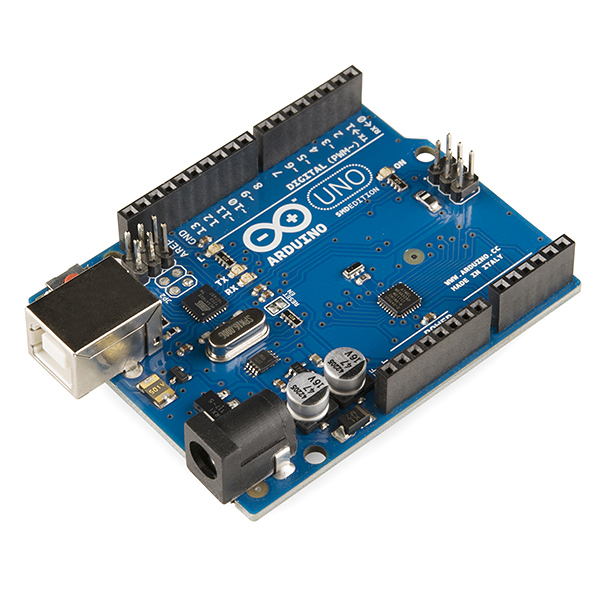
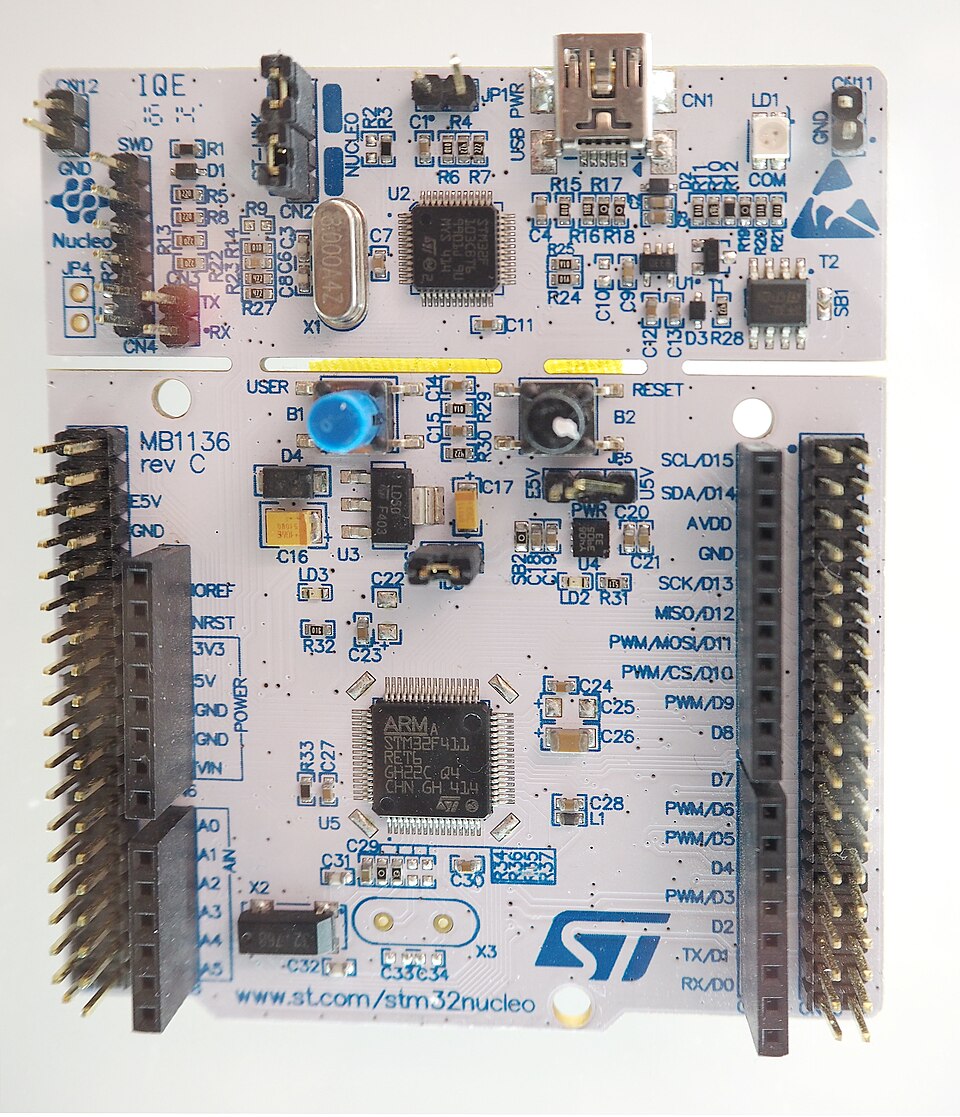
위 두 보드가 입문에 가장 많이 쓰인다. Arduino Uno 의 가운데 검은 칩 하나가 위 그림의 전부를 담고 있고, Nucleo 는 위쪽 절반이 디버거(ST-LINK)라 별도 장비 없이 브레이크포인트를 걸 수 있다.
프로그램이 끝나면 안 된다
int main(void) {
    init_clock();
    init_gpio();

    while (1) {              // ← 이 루프가 없으면 안 된다
        led_toggle();
        delay_ms(500);
    }
    // 여기에 도달하면 안 된다
}
while(1)을 빼면 어떻게 되나. 컴파일러가 만든 시작 코드(startup)에서 main을 호출하는데, main이 반환하면 대개 무한 루프에 갇히거나 리셋된다. 구현에 따라 다르므로 의존하면 안 되는 동작이다.
이것이 슈퍼루프(superloop) 이고, OS 없는 임베디드의 기본 실행 구조다.
while (1) {
    read_sensors();          // ① 입력
    compute_control();       // ② 판단
    drive_actuators();       // ③ 출력
    feed_watchdog();         // ④ "나 살아 있다" 신고
}
이 한 바퀴를 주기(cycle) 라 하고, 그 시간이 시스템의 응답성을 정한다. 한 단계가 오래 걸리면 나머지 전부가 밀린다 — 우선순위도 선점도 없기 때문이다. 그래서 임베디드에서 delay_ms(500) 같은 코드는 초보의 표식이다. 그 0.5초 동안 아무것도 못 한다.
응답 시간을 수로 따져 보기
"버튼을 누르면 100ms 안에 반응해야 한다"는 요구가 있다고 하자. 슈퍼루프에서 이 요구를 만족하는지는 한 바퀴의 최악 시간으로 판단한다.
| 단계 | 평균 | 최악 | 비고 |
|---|---|---|---|
read_sensors() | 2 ms | 5 ms | I²C 재시도가 붙을 때 |
compute_control() | 1 ms | 3 ms | 분기에 따라 |
drive_actuators() | 0.5 ms | 1 ms | |
log_to_uart() | 1 ms | 40 ms | 버퍼가 찼을 때 블로킹 |
| 한 바퀴 | 4.5 ms | 49 ms |
- 버튼은 최악의 경우 한 바퀴를 통째로 기다린 뒤 읽히므로 응답 지연은 최대 49 ms. 요구(100ms)는 만족한다.
- 그런데
log_to_uart하나가 최악의 80% 를 차지한다. 여기에 기능을 조금만 더 얹으면 바로 한계를 넘는다. 평균 4.5ms 만 보고 있으면 이 위험이 안 보인다.
핵심 — 슈퍼루프의 응답 시간은 모든 단계의 최악 시간의 합이다. 그래서 임베디드에서는 "평균 얼마"가 아니라 "최악 얼마" 로 말하는 습관이 중요하다. 블로킹 함수 하나가 전체 시스템의 실시간성을 결정한다.
대응은 셋이다 — ① 오래 걸리는 일을 인터럽트·DMA 로 넘기기, ② 상태 기계로 쪼개 한 바퀴에 조금씩 진행하기, ③ 정말 필요하면 RTOS 로 선점 구조 만들기(16편).
왜 OS를 안 쓰나
안 쓰는 게 아니라 필요가 없거나 감당이 안 되는 것이다.
- 메모리 — 리눅스 커널만 수 MB다. SRAM 128KB에는 들어가지 않는다
- 부팅 시간 — 에어백 제어기가 3초 뒤에 준비되면 의미가 없다
- 결정성 — 범용 OS는 "대체로 빠르다"를 보장하지 답이 언제 나오는지는 보장하지 않는다. 모터 제어는 매 1ms마다 반드시 계산이 끝나야 한다
세 번째가 특히 중요하다. 임베디드에서 자주 요구되는 것은 평균 성능이 아니라 최악 시간의 상한이다. 평균 100µs에 최악 50ms인 시스템보다, 평균 500µs에 최악 600µs인 시스템이 낫다.
실시간(real-time)은 "빠르다"가 아니다. 정해진 시간 안에 반드시 끝난다는 뜻이다. 시간 안에 못 끝내면 답이 맞아도 실패다.
- 경성(hard) — 놓치면 시스템 실패. 에어백, 모터 제어
- 연성(soft) — 놓치면 품질 저하. 오디오 버퍼, 화면 갱신
전원을 넣으면 무슨 일이 일어나나
① 전원 인가 · 리셋 해제
② 0x0000_0000 에서 스택 포인터 초기값을 읽어 SP 에 넣는다
③ 0x0000_0004 에서 Reset_Handler 주소를 읽어 거기로 점프
④ startup 코드가
     .data 를 Flash → SRAM 으로 복사   (초기값 있는 전역변수)
     .bss 를 0 으로 채운다             (초기값 없는 전역변수)
     클럭·FPU 설정
⑤ main() 호출
주소 0번지의 첫 4바이트가 코드가 아니라 스택 포인터 값이라는 점이 특이하다. Cortex-M은 리셋 시 이 둘을 하드웨어가 자동으로 읽는다 — 그래서 초기화 코드가 실행되기도 전에 스택이 준비돼 있다.
.data 복사가 왜 필요한가 하면 — Flash는 실행 중에 쓸 수 없고 SRAM은 전원이 꺼지면 사라지기 때문이다. 초기값은 Flash에 저장해 두고, 부팅할 때 SRAM으로 옮긴다.
int  counter = 42;      // .data — Flash 에 42 가 있고 부팅 시 SRAM 으로 복사된다
int  total;             // .bss  — 0 으로 채워진다. Flash 공간을 안 쓴다
const int MAX = 100;    // .rodata — Flash 에 남는다. 복사 안 한다
전역 배열을 = {0}으로 초기화하면 .data로 가서 Flash를 그 크기만큼 잡아먹는다. 그냥 두면 .bss라 Flash를 안 쓴다. 1KB 배열 하나가 펌웨어 크기를 1KB 늘리는 차이다.
개발 흐름이 다르다
PC        코드 → 컴파일 → 실행 → 로그 확인
MCU       코드 → 크로스 컴파일 → 플래시 굽기 → 보드에서 실행
                                    └ 로그를 어디로 볼 것인가?
printf를 쓸 화면이 없다. 그래서 디버깅 수단을 처음부터 마련해 둔다.
// ① UART 로 로그 — 가장 흔하다
printf("adc=%d\r\n", value);        // 시리얼 터미널로 나온다

// ② LED — 화면도 UART 도 없을 때
led_on();  /* 여기까지 왔다 */

// ③ GPIO 토글 + 오실로스코프 — 시간을 재야 할 때
GPIOA->BSRR = (1 << 5);     // 측정 시작
compute();
GPIOA->BSRR = (1 << 21);    // 측정 끝  → 파형의 폭이 곧 실행 시간
③이 임베디드다운 방법이다. 핀 하나를 올렸다 내리고 그 폭을 오실로스코프로 재면 함수 실행 시간을 마이크로초 단위로 알 수 있다. 로그를 찍으면 그 로그 자체가 시간을 잡아먹어 측정이 왜곡되는데, GPIO 토글은 한두 클럭이면 끝난다.
크로스 컴파일
개발하는 기계와 코드가 돌 기계가 다르다. PC(x86)에서 만든 실행 파일은 MCU(Arm)에서 돌지 않으므로, 대상 아키텍처용 도구 모음으로 빌드한다. 이것을 크로스 컴파일이라 부르고, 툴체인 이름에 대상이 그대로 적혀 있다.
arm-none-eabi-gcc -mcpu=cortex-m4 -mthumb -mfpu=fpv4-sp-d16 -mfloat-abi=hard \
    -O2 -ffunction-sections -fdata-sections \
    -T stm32f4.ld -Wl,--gc-sections \
    main.c startup.s -o firmware.elf

arm-none-eabi-objcopy -O binary firmware.elf firmware.bin
arm-none-eabi-size firmware.elf
#    text    data     bss     dec     hex filename
#   24512     108    8192   32812    802c firmware.elf
#   │         │      └ SRAM 을 쓰지만 Flash 는 안 쓴다
#   │         └ Flash 와 SRAM 을 둘 다 쓴다 (복사되므로)
#   └ Flash 사용량
arm-none-eabi-는 "ARM 아키텍처 · OS 없음(none) · 임베디드 ABI" 라는 뜻이다. none이 OS가 없다는 표시다.
Flash 사용량 = text + data, SRAM 사용량 = data + bss(+ 스택 + 힙). 이 숫자를 매 빌드마다 보는 습관이 중요하다 — 용량이 넘치면 컴파일이 아니라 링크에서 실패하고, 그 오류 메시지는 초보에게 불친절하다.
SRAM 예산 — size 가 안 보여 주는 것까지 세어야 한다
arm-none-eabi-size 가 알려 주는 것은 data + bss 까지다. 그런데 실제로 SRAM 을 먹는 것은
그게 전부가 아니다. 스택과 힙은 링크 시점에 크기가 안 정해지므로 이 숫자에 안 잡힌다.
SRAM 128KB 시스템의 예산표를 실제로 짜 보면 이렇다.
| 항목 | 크기 | size 에 잡히나 |
|---|---|---|
.data (초기값 있는 전역) | 108 B | ✓ |
.bss (초기값 없는 전역) | 8,192 B | ✓ |
| 메인 스택 | 4,096 B | ✗ |
| 인터럽트용 여유 | 1,024 B | ✗ |
| DMA 버퍼 2채널 | 4,096 B | ✓ (보통 .bss) |
| 합계 | 17,516 B (13.4%) | 남은 113,556 B |
함정 —
size로는 통과했는데 실행 중에 죽는 경우가 여기서 나온다. 링커는.data+.bss가 SRAM 에 들어가는지만 검사하고, 스택이 자라다.bss를 침범하는 것은 검사하지 않는다. 그래서 전역 배열을 늘려 SRAM 을 95% 채워 놓으면, 링크는 성공하고 깊은 함수 호출이 일어나는 순간 스택이 전역 변수를 덮어쓴다.증상은 "관계없는 변수가 저 혼자 바뀐다" 로 나타나 원인을 찾기가 매우 어렵다. 대응은 ① 링커 스크립트에 최소 스택 크기를 선언해 링크 시점에 검사시키기(06편), ② 스택 영역을 특정 패턴으로 채워 두고 최고 수위(high-water mark)를 측정하기(23편).
한눈에 정리
main은 끝나면 안 된다 — 돌아갈 OS가 없다.while(1)슈퍼루프가 기본 구조- MCU는 메모리가 칩 안에 있어 부품이 적고 수십 µs 만에 부팅한다
- 한 단계가 늦으면 전부 밀린다 — 슈퍼루프에는 우선순위도 선점도 없다.
delay_ms는 그래서 위험하다 - 실시간은 빠른 것이 아니라 시간 안에 반드시 끝나는 것 — 평균보다 최악 상한이 중요하다
- 0번지의 첫 4바이트는 코드가 아니라 스택 포인터 초기값이고, 다음 4바이트가 Reset_Handler 주소다
.data는 Flash에서 SRAM으로 복사되고.bss는 0으로 채워진다 —= {0}초기화가 Flash를 잡아먹는 이유- 디버깅은 UART 로그 · LED · GPIO 토글 — 시간을 잴 때는 GPIO 토글 + 오실로스코프가 정확하다
arm-none-eabi-size로 Flash·SRAM 사용량을 매 빌드 확인 — 넘치면 링크에서 터진다
꼬리질문 대비
- "MCU 에서
main이return하면 어떻게 되나?" → 돌아갈 OS 가 없다. startup 코드의 무한 루프에 갇히거나 리셋된다 — 구현 정의라 의존하면 안 된다- "실시간(real-time)이 '빠르다'와 어떻게 다른가?" → 정해진 시간 안에 반드시 끝나는 것. 평균이 아니라 최악 시간의 상한이 요구된다
- "전역 배열을
= {0}으로 초기화하면 무엇이 달라지나?" →.bss대신.data로 가서 그 크기만큼 Flash 를 잡아먹는다- "
size가 보여 주는 SRAM 사용량으로 충분한가?" → 아니다. 스택과 힙이 빠져 있어 링크가 통과해도 실행 중 스택이 전역을 침범할 수 있다
출처 — Joseph Yiu, The Definitive Guide to Arm Cortex-M3 and Cortex-M4 Processors 3e · Arm, Cortex-M4 Devices Generic User Guide(DUI 0553) · GNU Arm Embedded Toolchain 문서